
Comment les assureurs et les banques peuvent-ils relever les défis analytiques les plus complexes d’aujourd’hui ? Chez Earnix, nous pensons que tout commence par poser les bonnes questions et se concentrer sur les véritables leviers de performance métier.
Dans cette série d’articles, nous explorons les principaux enjeux de l’analytique financière, en abordant des problématiques complexes, en améliorant les modèles et en renforçant la compétitivité. Nos premiers articles portaient sur l’analyse de modèles, Auto-XGBoost, le regroupement intelligent (une fonctionnalité d’Auto-GLM) et le sélecteur de niveau hiérarchique (un algorithme de prétraitement). Nous avons également récemment abordé les modèles linéaires généralisés automatiques.
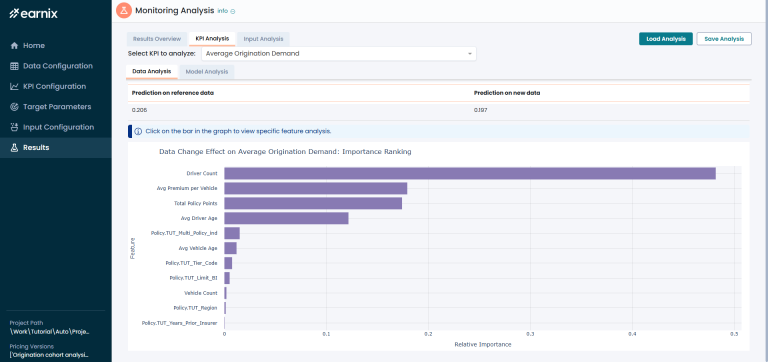
Dans cet article, nous présentons “Monitoring Data with KPIs in Mind”, une fonctionnalité de notre Monitoring Analysis Lab qui relie directement la dérive des données à l’impact métier.
La limite du suivi standard
Le suivi traditionnel de la dérive se concentre sur l’identification des variations statistiques dans la distribution des données. En pratique, toutes les variations n’ont pas la même importance.
Prenons deux exemples :
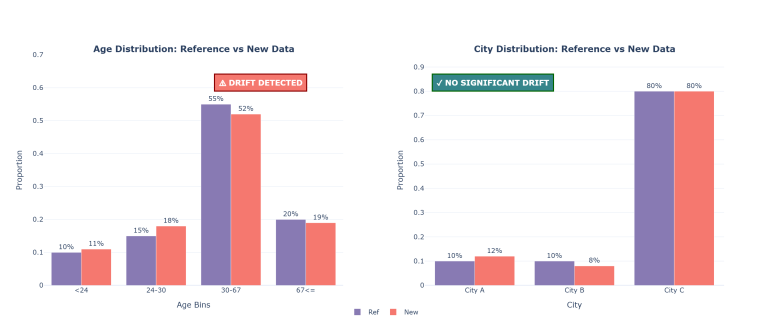
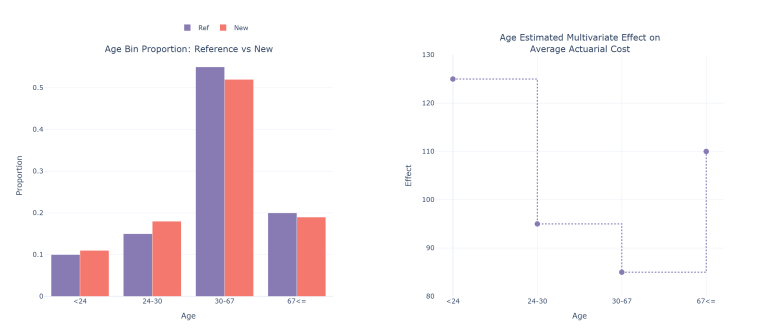
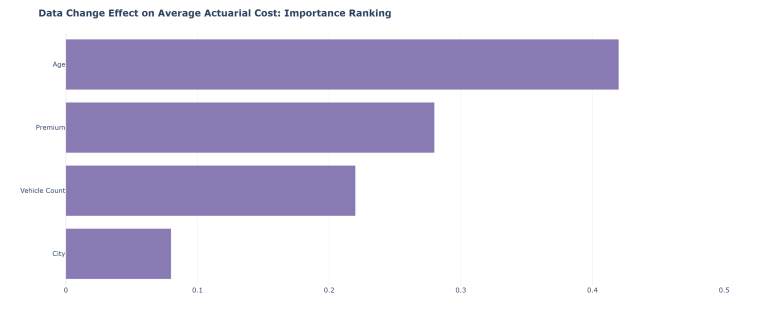
Si la proportion de clients de moins de 24 ans passait de 10 % à 11 %, la variation pourrait sembler minime. Cependant, si l’âge a une forte incidence sur le coût actuariel, l’impact pourrait être significatif.
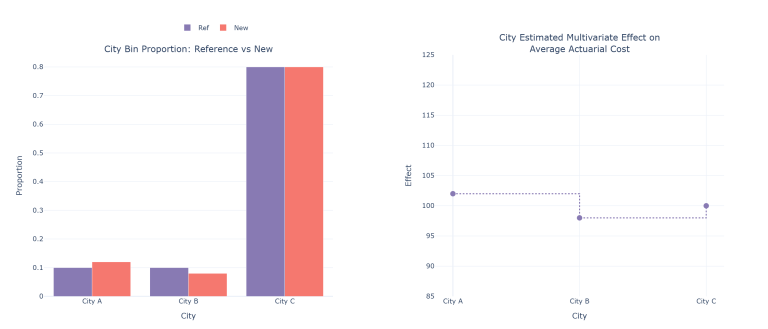
Considérons maintenant une variation entre la ville A et la ville B, passant de 10 % / 10 % à 12 % / 8 %. Cela peut déclencher une alerte de dérive, mais si les deux villes se comportent de manière similaire, l’impact sur l’activité est minime.